URLの%E3はなぜ出る?日本語が%表記になる仕組み
URLの日本語は、1文字をUTF-8の3バイトに分け、1バイトずつ「%」と2桁の16進数で書くので%E3%81%82のような形になります。ひらがな・カタカナがE3で始まる理由、先頭の値から中身の見当をつける表、戻せない%表記の3つの原因を、実際の変換結果で確かめます。
公開読了目安 約5分
この記事の要点
- 「あ」はUTF-8で E3 81 82 の3バイトになり、%E3%81%82 と書かれる
- ひらがな・カタカナ・句読点はUTF-8で E3 から始まるので、日本語のURLは %E3 だらけになる
- 日本語1文字は%表記で9文字、絵文字は12文字に増える
- %の先頭の値で、ひらがな・漢字・全角英数・絵文字の見当がつく
- 戻せない%表記は、古い文字コード・二重の変換・+の扱いの3つを疑う
目次
URL の日本語が %E3%81%82 のような形になるのは、文字をバイトに分けて 1 つずつ % で書くからです。
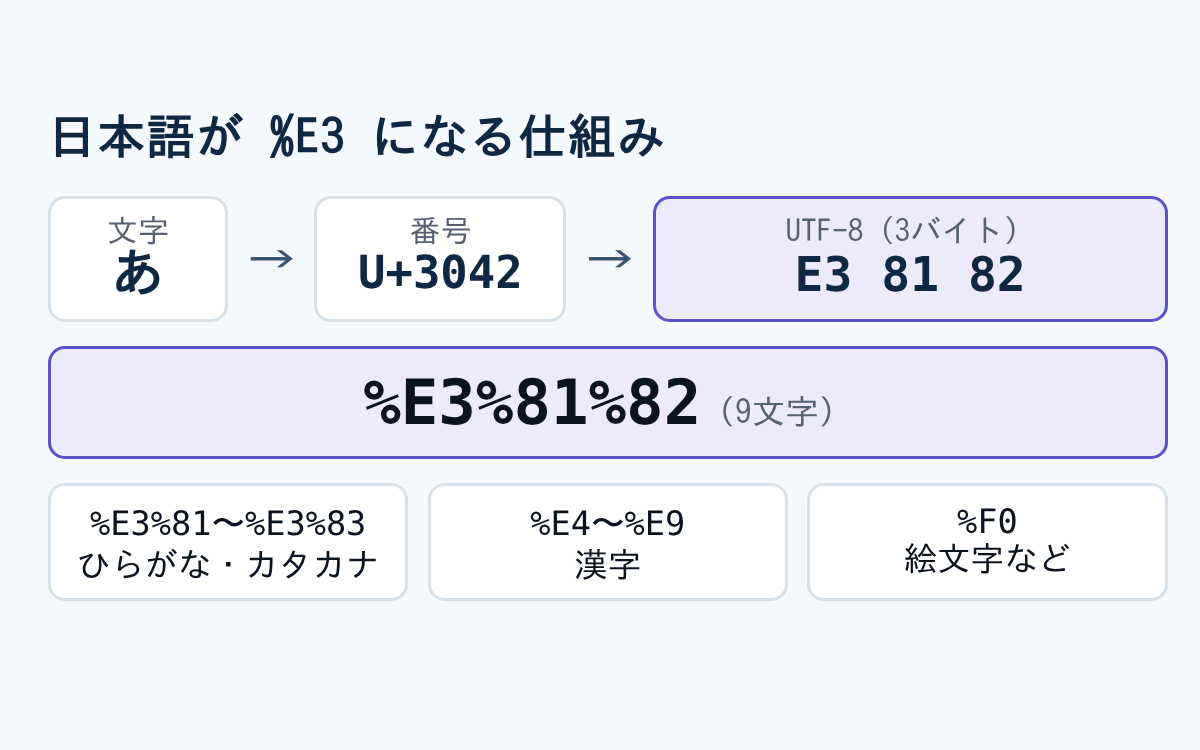
UTF-8 で「あ」は E3・81・82 の 3 バイトなので、% と 2 桁の 16 進数を 3 組並べた %E3%81%82 の 9 文字になります。
検索結果やブログの記事を共有すると、相手に届く URL がこの形で読めないことがあります。
仕組みが分かれば、% の並びの先頭を見るだけで「ひらがなか、漢字か、絵文字か」の見当がつき、壊れた URL の原因も絞れます。
1 文字が 3 つの「%」になるまで
コンピューターの中の文字は、番号で管理されています。 「あ」の番号は U+3042 で、これを UTF-8 という決まりで 3 バイトに分けると E3・81・82 になります。
URL の決まり(RFC 3986)では、そのまま書けない 1 バイトを % と 2 桁の 16 進数で表します。
3 バイトなら 3 組なので、「あ」は %E3%81%82 です。
1 文字が何文字に増えるかは、バイトの数で決まります。
| 文字 | %表記 | 字数 |
|---|---|---|
| A | A | 1 |
| é | %C3%A9 | 6 |
| あ | %E3%81%82 | 9 |
| 😀 | %F0%9F%98%80 | 12 |
日本語の 1 文字は、ほとんどが 9 文字になります。
「東京タワー」の 5 文字は、% 表記で 45 文字です。
日本語の URL が %E3 だらけになる理由
UTF-8 の 3 バイトの文字は、番号の上の桁が先頭のバイトに入ります。 ひらがな・カタカナ・句読点の番号は U+3000〜U+30FF に集まっているので、先頭のバイトがそろって E3 になります。
漢字の多くは U+4E00〜U+9FFF にあり、先頭は E4〜E9 に分かれます。
小学校で習う 1,026 字を変換すると、すべて %E4〜%E9 で始まる 9 文字になりました。
先頭の値から中身の見当をつける
% の並びの最初の 1〜2 組を見ると、何の文字かの見当がつきます。
| 始まり | 中身の見当 |
|---|---|
| %E3%80 | 句読点・かっこ・全角スペース |
| %E3%81〜%E3%83 | ひらがな・カタカナ |
| %E4〜%E9 | 漢字 |
| %EF%BC・%EF%BD | 全角の英数字・記号 |
| %F0 | 絵文字など |
| %C2・%C3 | é や © など |
たとえば %E3%80%80 は全角スペース、%EF%BC%91 は全角の「1」です。
検索語に全角スペースや全角数字が混ざっていると、ここで気づけます。
そのまま残る文字と、大文字・小文字
RFC 3986 は、英字・数字と - . _ ~ の 4 つを、変換しなくてよい文字としています。
これらは % にすると別の書き方になるだけなので、変換しないよう勧められています。
JavaScript の encodeURIComponent は、これに ! ' ( ) * を加えた文字を残します。
道具によって残す記号が少し違うので、! や * の扱いが違っても壊れたとは限りません。
%e3 と %E3 は同じ 1 バイトを表します。
RFC 3986 は、作る側は大文字にそろえるよう勧めています。
戻せない %表記の 3 つの原因
古い文字コードで作られた URL
UTF-8 が広まる前は、日本語のページで Shift_JIS という別の文字コードがよく使われていました。
Shift_JIS の「あ」は 82・A0 の 2 バイトなので、%82%A0 になります。
この並びを UTF-8 として戻そうとすると、意味のあるバイトの並びになりません。 URLエンコード・デコードツールに入れると、「不正なURLエンコードです」と表示されます。
UTF-8 では、%80〜%BF は %E3 などの後ろに続く値で、文字の頭には来ません。
= や / の直後がいきなり %82 や %83 で始まっていたら、Shift_JIS の可能性を疑います。
文字コードの取り違えは、CSVをExcelで開くと文字化けする原因と直し方でも扱っています。
2 回変換されている
% 自体も、1 回変換すると %25 になります。
すでに変換済みの URL をもう一度変換すると、%E3%81%82 は %25E3%2581%2582 になります。
%25E3 や %2581 のように、%25 の後ろに 16 進数の 2 桁が続く形が並んでいたら、2 回変換された合図です。
1 回戻すと %E3%81%82 が出てくるので、もう 1 回戻せば「あ」になります。
「+」とスペース
Web のフォームから送る形式では、スペースを %20 ではなく + で書きます。
WHATWG の URL の仕様にある、フォームの送信形式の決まりです。
この形式の値を、+ を特別扱いしない方法で戻すと、+ が残ってスペースになりません。
逆に、値の中の本物の + は %2B と書かないと、フォームの形式として読む受け取り側ではスペースに変わります。
1+1=2 を値として送るなら、1%2B1%3D2 が正しい形です。
フォームから来た値を戻すときは、+ をスペースとして扱う方法で戻します。
ドメイン名は %にならない
https:// の直後のドメイン名の部分は、% ではなく別の決まりで変換されます。
日本語のドメイン名は、xn-- で始まる英数字の並びになります。
xn-- の読み方は、QRコードの中身を開く前に確かめる手順で扱っています。
% 表記を戻す道具では、ドメイン名の部分は元に戻りません。
関連記事
- URLエンコード・デコードの使い方:ツールの操作手順と変換する範囲の選び方
- Base64で日本語が文字化けする理由とUTF-8:同じ UTF-8 のバイトを Base64 で書くときの話
- QRコードの中身を開く前に確かめる手順:URL のどこを見て行き先を確かめるか
まとめ
日本語の URL の % は、文字を UTF-8 のバイトに分けて、1 バイトずつ書いた結果です。
ひらがな・カタカナは E3 から始まる 3 バイトなので、%E3 が並びます。
戻せないときは、古い文字コード・2 回の変換・+ の扱いの順に確かめます。
読みたい URL は、URLエンコード・デコードツールをデコードに切り替えて貼れば、元の文字で確かめられます。
参考・出典
- RFC 3986: Uniform Resource Identifier (URI): Generic Syntax(2.1 Percent-Encoding / 2.3 Unreserved Characters) — IETF (2026-10-09 閲覧)
- URL Standard(application/x-www-form-urlencoded) — WHATWG (2026-10-09 閲覧)
- encodeURIComponent() — MDN Web Docs (2026-10-09 閲覧)
本記事は上記の公的機関・公式情報源を参考にしています。最新の情報は各リンク先をご確認ください。
あわせて読みたい
同じテーマ・関連ツールの記事です。